Mistral OCR 4.1؛ بررسی مدل استخراج ساختاریافته اسناد با Bounding Box و Confidence
آخرین راستیآزمایی: ۱۳ سپتامبر ۲۰۲۶
تاریخ عرضه: روز دقیق عرضه در متن فعلی ثبت نشده است.
قیمت و شیوهٔ محاسبه: OCR API ۴ دلار / ۱۰۰۰ صفحه؛ Annotated Page / Document AI ۵ دلار / ۱۰۰۰ صفحه تعرفه و دسترسی را برای زمان خرید دوباره در منبع رسمیِ مقاله بررسی کنید.
مقدمه؛ OCR دیگر فقط خواندن چند خط متن نیست
OCR سنتی معمولاً تصویر صفحه را به رشتهای از کلمات تبدیل میکرد. این خروجی برای جستجوی ساده کافی بود، اما وقتی سند چندستونه، جدول، فرمول، امضا، Header و Caption دارد، فقط دانستن کلمات کافی نیست. سیستم باید بداند هر بخش کجاست، چه نقشی دارد و تا چه اندازه میتوان به استخراج آن اعتماد کرد.
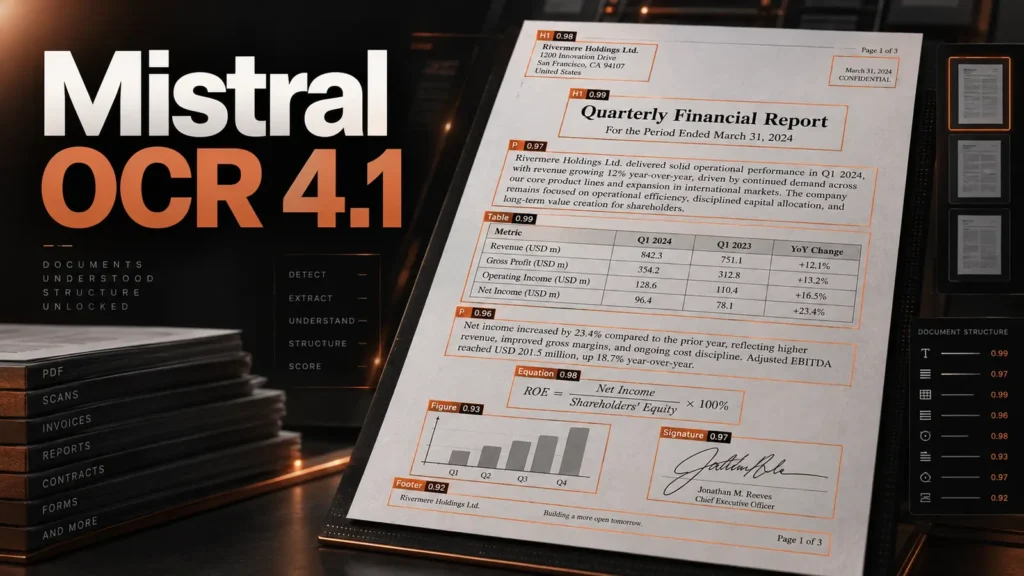
Mistral OCR 4.1 برای همین لایه ساختاری Document Intelligence طراحی شده است. این سرویس یک صفحه را به Markdown و مجموعهای از Blockهای مرتب تبدیل میکند؛ برای هر Block میتواند مختصات، نوع ساختاری و Confidence برگرداند. نتیجه برای RAG، آرشیو دیجیتال، استخراج فاکتور و Human-in-the-loop بسیار مفیدتر از متن تخت است.
Mistral AI نسخه 4.1 را ۱۶ ژوئیه ۲۰۲۶ منتشر و در ۳۱ اوت همان سال GA اعلام کرد. تفاوت برجسته آن با OCR 4.0، اضافه شدن Confidence score در سطح Block است. در Master List این پروژه نام «Mistral OCR 4.1» حفظ شده، اما نام رسمی صفحه محصول «OCR 4.1» است.
Mistral OCR 4.1 چیست؟
OCR 4.1 جدیدترین Snapshot سرویس OCR تجاری Mistral و موتور Document AI این شرکت است. ورودی آن سند یا تصویر و خروجی پایهاش محتوای استخراجشده، Markdown صفحه، اطلاعات تصویر و جدول، Hyperlink، ابعاد صفحه و Metadata مصرف است.
اگر include_blocks=true فعال شود، هر صفحه آرایهای از Blockها برمیگرداند. هر Block شامل نوع محتوا، مختصات گوشه بالا-چپ و پایین-راست و متن استخراجشده است. انواع رسمی عبارتاند از:
text،titleوlist؛table،imageوequation؛caption،codeوreferences؛aside_text،header،footerوsignature.
این مدل یک Chatbot عمومی نیست. وظیفهاش Parse کردن سند و ساخت خروجی قابلمصرف برای نرمافزار است. برای سؤالوپاسخ یا خلاصهسازی، خروجی OCR به مدل زبانی یا قابلیت Document Q&A متصل میشود.
جایگاه 4.1 در خانواده Mistral OCR
نسخه اولیه Mistral OCR در مارس ۲۰۲۵ عرضه شد؛ OCR 2 در مه ۲۰۲۵ و OCR 3 در دسامبر همان سال ادامه مسیر بودند. OCR 4.0 در ۲۳ ژوئن ۲۰۲۶ Bounding Box سطح پاراگراف و Structural block label را اضافه کرد. نسخه 4.1 همین پایه را با Confidence سطح Block کاملتر کرد.
Aliasهای mistral-ocr-latest و mistral-ocr-4 از ۱۶ ژوئیه ۲۰۲۶ به 4.1 اشاره میکنند. برای Production بهتر است شناسه ثابت mistral-ocr-4-1 استفاده شود تا تغییر Alias رفتار Pipeline را بیخبر عوض نکند.
OCR 4.0 هنوز در فهرست مدلها دیده میشود و OCR 3 برای Integrationهای موجود باقی مانده است، اما Mistral 4.1 را جدیدترین سرویس معرفی میکند. نسلهای 2025 قدیمیتر یا Deprecated هستند؛ هنگام مهاجرت باید خروجی JSON، جدول و Placeholderهای تصویر Regression test شوند.
قابلیتهای اصلی Mistral OCR 4.1
استخراج متن با حفظ ساختار و ترتیب خواندن
سرویس برای هر صفحه Markdown تولید میکند و تلاش دارد Heading، Paragraph، List، Table و Equation را در ترتیب خواندن حفظ کند. این ساختار برای Chunking بهتر است؛ زیرا یک عنوان از پاراگراف زیرش جدا و ستونهای صفحه بیمنطق به هم دوخته نمیشوند.

هیچ مدل OCR بیخطا نیست. صفحه کج، Scan کمنور، Watermark، دستخط و Font بسیار ریز میتوانند ترتیب یا متن را خراب کنند. Preview بصری و نمونهگیری انسانی برای آرشیو حساس لازم است.
Bounding Box سطح پاراگراف
با include_blocks=true، مختصات هر Block نسبت به صفحه برگردانده میشود. رابط کاربری میتواند هنگام نمایش پاسخ RAG، همان ناحیه سند را Highlight کند؛ ابزار Redaction نیز میتواند بهجای جستجوی مبهم متن، محدوده مشخص صفحه را هدف بگیرد.
Bounding Box بهتنهایی معنای قطعی نمیسازد. اگر مدل یک Caption را بهعنوان Paragraph تشخیص دهد، مختصات درست اما Label غلط خواهد بود. برای همین 4.1 Confidence نوع Block را هم ارائه میکند.
Confidence در سطح Page، Block و Word
پارامتر confidence_scores_granularity سه مقدار اصلی دارد:
page: میانگین و کمینه Confidence صفحه؛block: آمار صفحه و Confidence محتوای هر Block، همراه Confidence نوع Block؛word: آمار صفحه و آرایه Confidence واژهها.
در سطح Block سه فیلد مهم وجود دارد: میانگین Confidence متن، کمترین Confidence متن و Confidence برچسب ساختاری. برای Block غیرمتنی مانند تصویر، Confidence محتوای متنی میتواند null باشد.
این نمره Probability کالیبرهشده برای همه Domainها نیست. Threshold مناسب فاکتور فارسی ممکن است با مقاله علمی انگلیسی فرق کند. تیم باید Confidence را روی Ground truth داخلی Calibrate کند و مثلاً فقط Blockهای کماعتماد را برای بازبینی انسانی بفرستد.
تشخیص جدول، فرمول، تصویر و امضا
مدل Table، Equation، Image، Signature و Caption را بهعنوان Block جدا میشناسد. خروجی جدول میتواند Inline Markdown باشد یا با table_format در فیلد جدا به شکل Markdown/HTML برگردد. تصویر و جدول با ID و Placeholder به خروجی صفحه متصل میشوند.
تشخیص وجود امضا به معنای احراز هویت امضاکننده یا اعتبار حقوقی سند نیست. OCR میتواند محدوده امضا و نام خوانا را استخراج کند؛ تأیید اصالت وظیفه سامانه دیگری است.
استخراج Header، Footer و Hyperlink
پارامترهای extract_header و extract_footer بخش تکراری صفحه را جدا میکنند. این جداسازی مانع میشود نام شرکت یا شماره صفحه در هر Chunk RAG تکرار شود. Hyperlinkهای تشخیصدادهشده نیز در خروجی صفحه قرار میگیرند.
برای سندی که Header آن حاوی شماره پرونده مهم است، حذف خودکار مناسب نیست. قبل از فیلتر کردن Blockها مشخص کنید کدام Metadata باید در Index بماند.
اسناد و فرمتهای رایج سازمانی
در API میتوان PDF را با URL عمومی، Base64 یا File upload ارسال کرد. تصویر با URL یا Base64 پذیرفته میشود. مستندات PNG، JPEG/JPG، AVIF، PDF، PPTX و DOCX را نمونه میزنند؛ اعلان OCR 4 نیز از PDF، DOC، PPT و OpenDocument نام میبرد.
پشتیبانی فرمت به معنای بازسازی کامل فایل اصلی نیست. Macro، Comment، Animation، Track Changes یا Object تعبیهشده ممکن است به خروجی OCR تبدیل نشوند. برای هر نوع فایل واقعی، Test مستقل لازم است.
پوشش چندزبانه گسترده
Mistral برای خانواده OCR 4 از ۱۷۰ زبان در ۱۰ گروه زبانی صحبت میکند و در ارزیابی داخلی، گروههای خاورمیانه و زبانهای کممنبع را نیز پوشش داده است. فهرست مثال شامل عربی، فارسی، عبری و چند خط Indic است.
این ادعا Vendor-reported است و کیفیت هر زبان یکسان نیست. برای فارسی باید اتصال حروف، نیمفاصله، اعداد فارسی/لاتین، متن راستبهچپ، جدول دوزبانه و تاریخ شمسی آزمایش شوند.
Structured Annotations و Document AI
علاوه بر OCR خام، میتوان JSON Schema برای document_annotation یا bbox_annotation تعریف کرد. Mistral میگوید در این حالت خروجی OCR به mistral-small-2603 داده میشود تا فیلدهای موردنظر را به شکل Schema تولید کند؛ Annotation تصویر نیز میتواند فراخوانی Vision-Language جداگانه ایجاد کند.
این تمایز در هزینه و اعتبار مهم است. متن OCR، Structured extraction و Annotation تصویر لایههای یکسانی نیستند. هر فیلد JSON باید با متن و Bounding Box منبع قابل ردیابی باشد.
Batch و استقرار سازمانی
برای آرشیو بزرگ، Batch API پردازش موازی و تخفیف دارد. Mistral OCR 4 را مدل متمرکز و کوچک توصیف کرده که امکان Self-managed deployment در یک Container برای مشتریان سازمانی دارد. Self-hosting عمومی و وزن آزاد همان مفهوم نیست؛ شرایط استقرار باید قراردادی بررسی شود.
قابلیتهایی که در این مدل نیست
OCR 4.1 Web Search، تولید تصویر، تولید ویدیو یا صوت ندارد و برای ورودی Raw audio/video ساخته نشده است. Tool Calling و Reasoning عمومی نیز قابلیت اصلی Endpoint OCR نیستند. هر Agent یا تصمیم تجاری روی خروجی، لایهای جدا از مدل استخراج سند است.
مهمترین نقاط قوت
خروجی قابل ردیابی تا صفحه و ناحیه
Bounding Box اجازه میدهد متن استخراجشده به محل واقعیاش روی صفحه متصل بماند. این ویژگی برای Citation، Audit، Redaction و رابط بررسی انسانی از چند امتیاز بیشتر در Character accuracy ارزش عملی بیشتری دارد.
Confidence سطح Block در نسخه 4.1
نسخه تازه میتواند بگوید کدام Paragraph یا Table و حتی نوع Block اعتماد پایینتری دارد. Pipeline بهجای رد یا قبول کل سند، فقط قسمت مشکوک را Escalate میکند. این طراحی هزینه بازبینی انسانی را هدفمند میکند.
پشتیبانی از Layoutهای متنوع
Table، Equation، Code، Signature و Aside labelهای جدا دارند. برای مقاله علمی، قرارداد، گزارش مالی و فرم سازمانی، حفظ این نقشها کیفیت Chunking و Retrieval را بهتر میکند.
قیمت صفحهای شفاف
API پایه ۴ دلار بهازای هزار صفحه است. این مدل قیمتگذاری برای آرشیو قابل پیشبینیتر از Token billing است. Batch طبق اعلان رسمی هزینه پایه را ۵۰٪ کاهش میدهد.
مسیر Cloud تا Self-hosting سازمانی
API برای شروع سریع مناسب است و Self-managed container برای Residency یا Compliance گزینه مهمی است. بااینحال قیمت و شرایط Self-host عمومی نیست و باید در TCO سختافزار و عملیات لحاظ شود.
محدودیتها و نقاط ضعف
Benchmark دقیق 4.1 منتشر نشده است
امتیازهای 85.20، 93.07 و 0.98 در اعلان OCR 4.0 منتشر شدهاند. Mistral برای Update 4.1 نتیجه عددی جدا یا مقایسه نسخهبهنسخه ارائه نکرده است. بنابراین این اعداد فقط نزدیکترین شواهد خانوادهاند و نه امتیاز قطعی Snapshot 4.1.

نتایج اصلی توسط سازنده بازتولید شدهاند
Mistral میگوید همه امتیازهای رقبا در جدولهای OCR 4 بازتولید داخلی هستند. نام و Raw score رقبا در متن قابلدسترس اعلان درج نشده است. ارزیابی انسانی Blind و Annotator مستقل دارد، اما Dataset و همه خروجیهای Pairwise عمومی نشدهاند.
خطای Ground truth و Scoring
خود Mistral توضیح میدهد که OlmOCRBench و OmniDocBench با معادله LaTeX معادل، شکست کلمه میان ستونها، Header/Footer و Annotation اشتباه مشکل دارند. Aggregate score میتواند خروجی درست را جریمه یا خطای واقعی را پنهان کند.
Confidence نیازمند کالیبراسیون Domain است
عدد 0.9 الزاماً به معنای ۹۰٪ صحت در Dataset شما نیست. اگر Threshold بدون Label داخلی انتخاب شود، Pipeline ممکن است سند خطرناک را Auto-approve یا حجم بزرگی از متن سالم را بیدلیل به انسان بفرستد.
OCR تصمیمگیر نیست
اعلان رسمی صریحاً کاربرد پزشکی تشخیصی، قضاوت حقوقی، تصمیم مالی حساس، سیستم Safety-critical و پردازش Real-time را خارج از دامنه میداند. خروجی مدل باید داده ورودی تصمیم باشد، نه تصمیم نهایی.
زبان و Layout واقعی میتواند متفاوت باشد
صفحه اسکنشده فارسی با Stamp، جدول راستبهچپ و متن دستنویس ممکن است با Benchmark عمومی فاصله داشته باشد. ۱۷۰ زبان یک عدد پوشش است و تضمین کیفیت برابر نیست.
Premier و وزن غیرعمومی
OCR 4.1 مدل Premier است. پارامتر، معماری دقیق، Context توکنی و وزن دانلود عمومی اعلام نشدهاند. Self-hosting سازمانی نباید با Open weights اشتباه گرفته شود.
کاربردهای واقعی Mistral OCR 4.1
ساخت RAG با Citation بصری
سند به Blockهای عنوان، متن و جدول تقسیم میشود. هر Chunk همراه شماره صفحه و Bounding Box وارد Index میشود. هنگام پاسخ، کاربر علاوه بر Citation میتواند همان ناحیه منبع را Highlight شده ببیند.
استخراج فاکتور با مسیر بازبینی انسانی
OCR متن و جدول Line item را میخواند؛ Annotation فیلدهایی مانند شماره فاکتور، تاریخ و مبلغ را در JSON میسازد. اگر کمینه Confidence یک Block از Threshold پایینتر باشد یا جمع اقلام با Total نخواند، سند به اپراتور میرود.
دیجیتالی کردن آرشیو چندزبانه
PDFهای اسکنشده به Markdown ساختاریافته تبدیل و Header/Footerهای تکراری جدا میشوند. قبل از Index، نمونهای از هر دهه، زبان و کیفیت Scan دستی ارزیابی میشود تا Bias آرشیو مشخص باشد.
پردازش مقاله علمی و گزارش فنی
Equation، Figure، Caption و Reference به Blockهای جدا تبدیل میشوند. این کار برای جستجوی فرمول و اتصال توضیح تصویر مفید است، اما معادلات حساس باید با رندر LaTeX و Ground truth بررسی شوند.
Redaction قابل ممیزی
مدل محل Paragraph و Block را میدهد؛ یک NER یا Rule جدا PII را تشخیص میدهد و ابزار PDF ناحیه را میپوشاند. فایل نهایی باید Rasterize/flatten و از نظر لایه متن پنهان کنترل شود؛ Bounding Box مدل بهتنهایی Redaction امن نیست.
طبقهبندی و Split پروندههای ترکیبی
نوع Block، عنوانها و Page boundary به Pipeline کمک میکنند یک PDF شامل چند قرارداد و ضمیمه را بخشبندی کند. تصمیم Split باید با Rule شماره پرونده و Test انسانی کنترل شود.
این مدل مناسب چه کسانی است؟
- تیمهای RAG و Enterprise Search؛
- کسبوکارهای پردازش فاکتور، فرم و قرارداد؛
- آرشیوها، کتابخانهها و پروژههای Digitization چندزبانه؛
- توسعهدهندگان Document AI و Workflowهای Agentic؛
- سازمانهای نیازمند Bounding Box، Citation و Human review؛
- تیمهای Compliance که گزینه Self-managed را بررسی میکنند.
برای خواندن چند تصویر ساده، OCR سبکتر یا موتور سنتی ممکن است ارزانتر باشد. برای تصمیم پزشکی یا حقوقی، OCR 4.1 فقط لایه استخراج است و متخصص انسانی ضروری میماند.
مشخصات فنی
| مشخصه | مقدار تأییدشده |
|---|---|
| Developer | Mistral AI |
| Model family | Mistral OCR / Document AI |
| Official name | OCR 4.1 |
| Release / GA | انتشار ۱۶ ژوئیه ۲۰۲۶؛ GA در ۳۱ اوت ۲۰۲۶ |
| Model type | OCR و Document Intelligence؛ Premier |
| API ID | mistral-ocr-4-1 |
| Aliases | mistral-ocr-latest و mistral-ocr-4 در تاریخ بررسی |
| Input | PDF، سند Office/OpenDocument و تصویر از URL، Base64 یا Upload بسته به نوع |
| Output | Markdown، Blockها، Bounding Box، جدول/تصویر، Hyperlink، Header/Footer، Confidence و JSON Annotation اختیاری |
| Block labels | متن، عنوان، فهرست، جدول، تصویر، معادله، Caption، Code، Reference، Aside، Header، Footer و Signature |
| Confidence granularity | Page، Block و Word |
| Languages | ادعای رسمی خانواده OCR 4: ۱۷۰ زبان در ۱۰ گروه |
| Context Window | بهصورت توکن عمومی اعلام نشده |
| Maximum Output | عمومی اعلام نشده؛ خروجی صفحهمحور است |
| Web Search / Tool Calling | خیر؛ متعلق به Pipeline میزبان نیست |
| Audio / Video / Generation | خیر |
| Batch API | بله |
| API availability | GA؛ /v1/ocr |
| Open weights | تأیید نشده؛ Self-managed سازمانی با قرارداد جدا |
۵ نمونه Prompt و Schema کاربردی
OCR خام معمولاً به Prompt طولانی نیاز ندارد؛ ارزش Prompt در Document Annotation و Instruction لایه ساختاری است.
۱. استخراج فاکتور به JSON
این سند را پردازش کن و خروجی را مطابق Schema شامل
invoice_number،issue_date،seller،buyer،currency،line_items،subtotal،taxوtotalبساز. هیچ عددی را محاسبه یا حدس نزن؛ مقدار ناخوانا راnullقرار بده و برای هر فیلد شماره صفحه و Block مرتبط را نگه دار.
۲. RAG با حفظ Citation
Blockها را در ترتیب خواندن برگردان. Header و Footer را جدا نگه دار، هر Table و Caption را به هم متصل کن و برای هر Chunk شناسه صفحه، Bounding Box و نوع Block بساز. متن دو Block نامرتبط را فقط برای رسیدن به طول ثابت ادغام نکن.
۳. کنترل Confidence سطح Block
include_blocks=trueوconfidence_scores_granularity="block"را فعال کن. هر Block با کمینه Confidence کمتر از Threshold داخلی را در صفhuman_reviewقرار بده؛ Block غیرمتنی با Confidence محتوایnullرا خطا تلقی نکن.
۴. گزارش علمی با فرمول
عنوانها، Paragraphها، Equationها، Figureها، Captionها و References را جدا استخراج کن. LaTeX را عین خروجی OCR نگه دار و هیچ فرمولی را بازنویسی نکن. ارتباط Figure با نزدیکترین Caption را همراه صفحه و مختصات ثبت کن.
۵. سند فارسی راستبهچپ
متن فارسی و اعداد را بدون ترجمه استخراج کن. ترتیب ستونها را از راست به چپ بررسی کن، نیمفاصله را بیدلیل حذف نکن و Stamp، امضا و متن دستنویس را Block جدا قرار بده. بخش ناخوانا را با Confidence و مختصات برای بازبینی انسانی علامت بزن.
بنچمارک و مقایسه عملکرد
وضعیت شواهد برای نسخه دقیق 4.1
Mistral برای 4.1 Benchmark تازه و تفکیکشده منتشر نکرده است. جدول زیر اعداد رسمی OCR 4.0/خانواده OCR 4 را نشان میدهد، چون نزدیکترین پایه فنی اعلامشدهاند. این امتیازها را نباید بدون آزمایش به 4.1 نسبت قطعی داد.
| Benchmark | چه چیزی را میسنجد؟ | نتیجه OCR 4 | تاریخ | وضعیت منبع |
|---|---|---|---|---|
| OlmOCRBench | کیفیت تبدیل PDF پیچیده و ترتیب/ساختار خروجی | ۸۵٫۲۰ | ۲۳ ژوئن ۲۰۲۶ | Vendor-reported؛ بازتولید داخلی Mistral |
| OmniDocBench | Parsing جامع اسناد، Layout و انواع محتوا | ۹۳٫۰۷ | ۲۳ ژوئن ۲۰۲۶ | Vendor-reported؛ با هشدار Scoring |
| Crawl Multilingual | OCR چندزبانه در هشت گروه ارزیابیشده | ۰٫۹۸ | ۲۳ ژوئن ۲۰۲۶ | Benchmark داخلی Mistral |
| Human preference | ترجیح خروجی در Pairwise blind روی ۶۰۰+ سند و ۱۲+ زبان | میانگین Win rate برابر ۷۲٪ | ۲۳ ژوئن ۲۰۲۶ | Vendor-organized؛ Annotatorهای مستقل |
منبع: اعلان رسمی Mistral OCR 4. سازنده میگوید OCR 4 در میان سیستمهای آزمودهشده اول بوده، اما Raw score و نام همه رقبا در متن عمومی درج نشدهاند؛ بنابراین برای پر کردن جدول رقیب، عدد حدس نمیزنیم.
آیا مقایسه مستقیم با رقبا ممکن است؟
| داده لازم | وضعیت عمومی برای Snapshot دقیق 4.1 |
|---|---|
| امتیاز مستقل 4.1 روی OlmOCRBench | قابل تأیید پیدا نشد |
| امتیاز مستقل 4.1 روی OmniDocBench | قابل تأیید پیدا نشد |
| Raw score رقبای جدول رسمی | در متن اعلان منتشر نشده |
| A/B عددی 4.1 در برابر 4.0 | منتشر نشده |
| ارزیابی Confidence سطح Block | Benchmark عمومی اعلام نشده |
مقایسه عددی 4.1 با Google Document AI، Azure AI Document Intelligence، Amazon Textract، Nanonets یا Parserهای Agentic بدون Dataset، نسخه و تنظیم یکسان منصفانه نیست. برخی سرویسها Character recognition، بعضی Field extraction و بعضی Question answering را میسنجند.
محدودیتهای خود Benchmarkها
Mistral پنج مشکل را گزارش کرده است: Ground truth اشتباه، LaTeXهای معادل با String متفاوت، Segment شدن Equation، شکست کلمه و ترتیب ستون، و Attribution متفاوت Header/Footer. این موارد نشان میدهند امتیاز Aggregate باید Directional دیده شود.
نتیجه Human preference به کاربرد واقعی نزدیکتر است، ولی هنوز Evaluation سازنده و Dataset غیرعمومی کامل است. برای سند فارسی، معیارهای مهمتر میتوانند Character/Word error، حفظ ترتیب RTL، دقت عدد و تاریخ، Table cell accuracy، Block IoU، دقت Block label و Calibration Confidence باشند.
Eval پیشنهادی Buffalo147 برای استفاده واقعی
حداقل ۲۰۰ صفحه از Layoutهای واقعی را Label کنید و نتایج را جداگانه گزارش دهید:
| معیار | دلیل اهمیت |
|---|---|
| CER/WER به تفکیک زبان | دقت کاراکتر و واژه |
| Exact match اعداد و شناسهها | جلوگیری از خطای مالی/پرونده |
| Table cell accuracy | صحت ساختار جدول، نه فقط متن |
| Reading-order accuracy | جلوگیری از ادغام ستونها |
| Block label F1 | دقت عنوان، جدول، معادله و امضا |
| Bounding-box IoU | تطابق محل Block با Ground truth |
| Confidence calibration | آیا Score واقعاً احتمال خطا را جدا میکند؟ |
| هزینه و p95 زمان هر صفحه | ظرفیت عملی Production |
OCR 4 در شواهد رسمی روی ساختار و چندزبانگی قوی است؛ اما مهمترین قابلیت جدید 4.1—Confidence سطح Block—هنوز Benchmark عمومی ندارد. رقیبی که در فاکتور فارسی یا دستخط Dataset شما بهتر Calibrate میشود، میتواند با امتیاز عمومی پایینتر انتخاب مناسبتری باشد.
مقایسه با رقبای مستقیم
| گزینه | نقطه قوت | محدودیت مقایسه | مناسبتر برای |
|---|---|---|---|
| Mistral OCR 4.1 | Bounding Box پاراگراف، Block label و Confidence بلوکی در API واحد | Benchmark مستقل دقیق 4.1 کم است | RAG، Citation و Human review ساختاری |
| Google Document AI | Processorهای سازمانی و اتصال عمیق به Google Cloud | قیمت/Processor و Dataset متفاوت | تیمهای کاملاً مستقر در GCP |
| Azure AI Document Intelligence | مدلهای Prebuilt و اکوسیستم Microsoft | معیار و Schema با Mistral یکسان نیست | Workflowهای Azure و Form processing |
| Amazon Textract | استخراج Form/Table و ادغام AWS | خروجی و Benchmark همشرط نیست | Pipelineهای AWS و S3 |
| Parserهای Agentic | امکان Reasoning و QA پیچیده روی سند | معمولاً Latency و هزینه بالاتر | سؤال پیچیدهای که استخراج خام کافی نیست |
برای انتخاب، فقط OCR accuracy را نسنجید. Data residency، Bounding Box، Confidence، Schema، Batch، Latency، قیمت، Audit trail و کیفیت زبان واقعی همگی تعیینکنندهاند.
قیمت و API
در صفحه رسمی OCR 4.1 و آخرین بررسی ۱۳ سپتامبر ۲۰۲۶:
| سرویس | قیمت استاندارد |
|---|---|
| OCR API | ۴ دلار / ۱۰۰۰ صفحه |
| Annotated Page / Document AI | ۵ دلار / ۱۰۰۰ صفحه |
| OCR از طریق Batch API | ۲ دلار / ۱۰۰۰ صفحه طبق تخفیف ۵۰٪ اعلان OCR 4 |
قیمت Annotation تصویر یا Callهای اضافه میتواند به تنظیمات Pipeline وابسته باشد؛ برآورد را با یک Batch واقعی کنترل کنید. Endpoint اصلی /v1/ocr است و مدل ثابت mistral-ocr-4-1 انتخاب مطمئنتری برای Version pinning محسوب میشود.
قیمت Self-managed عمومی نشده است. Storage، Egress، Upload، Human review و مدل زبانی پس از OCR نیز در نرخ صفحهای پایه نیستند. قیمتها ممکن است تغییر کنند و باید پیش از قرارداد دوباره بررسی شوند.
شروع استفاده از Mistral OCR 4.1 در Buffalo147 AI
برای آزمون درست، یک PDF تمیز و یک سند واقعاً دشوار از کار خودتان آماده کنید. خروجی Markdown را کنار Blockها، Bounding Box و Confidence ببینید و فقط به ظاهر متن توجه نکنید. سپس Threshold بازبینی را براساس خطاهای همان Dataset تنظیم کنید.
شروع استفاده از Mistral OCR 4.1 در Buffalo147 AI
جمعبندی؛ ارزش 4.1 در قابلیت اعتمادپذیری Pipeline است
مزیت اصلی Mistral OCR 4.1 فقط خواندن متن نیست؛ ساخت یک نمایش قابلردیابی از سند است. Paragraph Bounding Box، Block label و Confidence سطح Block اجازه میدهند RAG Citationمحور، Redaction، استخراج فاکتور و Human review دقیقتر ساخته شوند.
محدودیت مهم، نبود Benchmark مستقل برای Snapshot دقیق 4.1 است. اعداد قدرتمند OCR 4 توسط سازنده گزارش شدهاند و خود Mistral نیز محدودیت Scoring را پذیرفته است. Confidence هم بدون Calibration داخلی نباید تصمیم خودکار بسازد.
اگر خروجی Markdown ساختاریافته، صفحه و مختصات منبع، چندزبانگی و API صفحهای میخواهید، 4.1 انتخاب جدی است. اگر فقط چند تصویر ساده دارید یا نیاز شما تصمیم تخصصی بالادستی است، سرویس سبکتر یا Pipeline چندمرحلهای ممکن است مناسبتر باشد.
سؤالات متداول
Mistral OCR 4.1 چیست؟
نسخه جدید سرویس OCR و Document AI شرکت Mistral است که اسناد و تصاویر را به Markdown و Blockهای ساختاریافته با Bounding Box، Label و Confidence تبدیل میکند.
تفاوت OCR 4.1 و OCR 4.0 چیست؟
4.0 Bounding Box پاراگراف و نوع Block را معرفی کرد؛ 4.1 Confidence score سطح Block را اضافه کرده است. Benchmark عددی جدا برای 4.1 منتشر نشده است.
آیا Mistral OCR 4.1 فارسی را پشتیبانی میکند؟
Mistral خانواده زبانهای خاورمیانه و فارسی را در پوشش OCR 4 ذکر میکند. کیفیت سند راستبهچپ، جدول و اسکن واقعی باید با Eval فارسی اختصاصی سنجیده شود.
چه فایلهایی را میتوان پردازش کرد؟
PDF، تصویر و فرمتهای رایج سند مانند DOCX و PPTX در مستندات نمونه آمدهاند. روش ارسال میتواند URL، Base64 یا File upload باشد و جزئیات هر فرمت باید در API کنترل شود.
آیا OCR 4.1 API دارد؟
بله. Endpoint /v1/ocr و شناسه نسخهای mistral-ocr-4-1 بهصورت GA در دسترساند. Alias mistral-ocr-latest نیز هنگام بررسی به همین نسخه اشاره میکرد.
قیمت آن چقدر است؟
OCR استاندارد ۴ دلار و صفحه Annotated برابر ۵ دلار بهازای هزار صفحه است. اعلان Mistral برای Batch تخفیف ۵۰٪ و نرخ ۲ دلار بهازای هزار صفحه ذکر میکند.
آیا وزن مدل قابل دانلود است؟
وزن عمومی برای 4.1 تأیید نشده است. Mistral گزینه Self-managed تکContainer را برای مشتری سازمانی مطرح کرده که شرایط قراردادی جدا دارد.
آیا میتوان به Confidence مدل اعتماد کامل کرد؟
خیر. Confidence برای اولویتبندی مفید است، اما باید روی اسناد واقعی شما Calibrate شود و برای تصمیم حساس با Rule و بازبینی انسانی ترکیب گردد.
OCR 4.1 بهتر است یا Google Document AI؟
پاسخ به نوع سند، زبان، Cloud، Schema، Residency و هزینه بستگی دارد. چون Benchmark مستقل همشرط دقیق 4.1 در دسترس نیست، A/B Test روی Dataset خودتان لازم است.
منابع و روش راستیآزمایی
- صفحه رسمی OCR 4.1
- Changelog رسمی انتشار و GA نسخه 4.1
- راهنمای رسمی OCR Processor و Block Confidence
- اعلان و Benchmark رسمی Mistral OCR 4
- مستندات رسمی Document AI
- مستندات Structured Annotations
- قیمت رسمی API مدل
این مقاله برای Buffalo147 AI از صفر نوشته شده است. امتیازهای Benchmark مربوط به OCR 4.0/خانواده OCR 4 هستند و بهعنوان Vendor-reported معرفی شدهاند؛ برای نسخه 4.1 هیچ عدد جداگانهای جعل یا استنتاج نشده است.